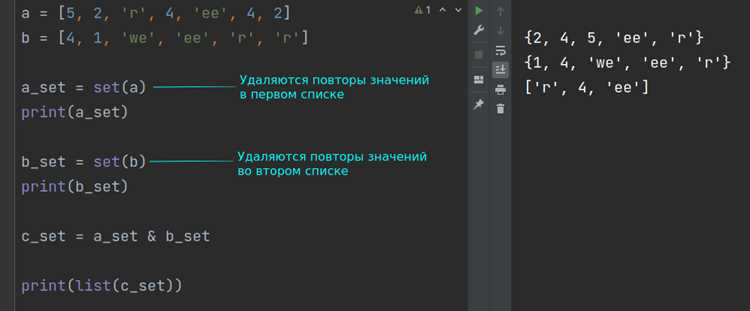
При работе с массивами в Java часто возникает задача удаления повторяющихся элементов. Это может быть связано с оптимизацией памяти, улучшением производительности или необходимостью обеспечить уникальность данных. Несмотря на наличие различных методов для решения этой задачи, каждый из них имеет свои особенности, которые влияют на выбор подхода в зависимости от конкретных условий.
Использование коллекций Java предоставляет несколько решений для удаления дубликатов. Например, классы HashSet и LinkedHashSet позволяют быстро избавиться от повторов, однако они имеют разные особенности. HashSet не сохраняет порядок элементов, в то время как LinkedHashSet сохраняет их в том порядке, в котором они были добавлены, что может быть критично в некоторых приложениях.
Если задача требует удаления дубликатов без использования коллекций, можно воспользоваться циклом и дополнительными структурами данных, такими как списки или массивы. Это решение подходит в ситуациях, когда нужно контролировать использование памяти или когда работа с коллекциями не оправдана. В таких случаях важно правильно организовать алгоритм для минимизации затрат по времени выполнения.
Кроме того, возможности Java Streams также стоит учитывать. С помощью методов distinct() и других встроенных функций можно сократить количество кода и ускорить выполнение операции удаления повторов, особенно когда работа ведется с большими объемами данных.
Как удалить дубли с помощью HashSet
Для удаления повторяющихся элементов из массива в Java можно использовать класс HashSet, который автоматически исключает дубликаты благодаря механизму хеширования. Основное преимущество этого подхода заключается в его простоте и высокой скорости обработки данных.
Пример использования HashSet для удаления дубликатов из массива выглядит следующим образом:
int[] array = {1, 2, 2, 3, 4, 4, 5};
Set set = new HashSet<>();
for (int i : array) {
set.add(i);
}
Integer[] uniqueArray = set.toArray(new Integer[0]);
В данном примере массив array содержит несколько повторяющихся элементов. После добавления элементов в HashSet, дубликаты автоматически удаляются. Результат можно преобразовать обратно в массив с помощью метода toArray(), что позволяет вернуть уникальные значения.
Применение HashSet имеет важное ограничение: элементы в нем не сохраняют порядок, в котором они были добавлены. Если порядок элементов важен, вместо HashSet стоит использовать LinkedHashSet, который сохраняет порядок добавления элементов. Однако, если порядок не критичен, использование HashSet будет предпочтительнее из-за его меньшего времени выполнения при больших объемах данных.
Для удаления дубликатов из массива примитивных типов, таких как int, необходимо будет использовать объектные типы, например, Integer, поскольку HashSet не может работать с примитивами напрямую. Для конвертации примитивных типов в объектные можно использовать автоупаковку или явное преобразование.
Использование LinkedHashSet для сохранения порядка элементов
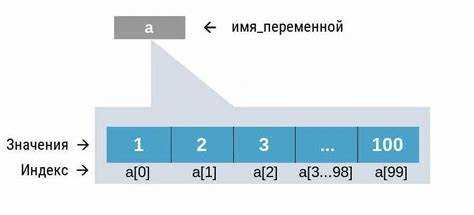
При удалении повторяющихся элементов из массива важно не только исключить дубликаты, но и сохранить порядок элементов, как в исходном массиве. В этом случае стоит использовать LinkedHashSet, который, в отличие от HashSet, сохраняет порядок добавления элементов.
Пример использования LinkedHashSet для удаления дубликатов и сохранения порядка элементов:
int[] array = {1, 2, 2, 3, 4, 4, 5};
Set set = new LinkedHashSet<>();
for (int i : array) {
set.add(i);
}
Integer[] uniqueArray = set.toArray(new Integer[0]);
В этом примере массив array содержит несколько повторяющихся элементов. При добавлении этих элементов в LinkedHashSet они автоматически становятся уникальными, при этом сохраняется их порядок.
Вот как будет выглядеть результат в виде таблицы:
| Индекс | Значение |
|---|---|
| 0 | 1 |
| 1 | 2 |
| 2 | 3 |
| 3 | 4 |
| 4 | 5 |
Как видно из таблицы, порядок элементов сохраняется, и дубликаты успешно удалены. Этот метод полезен, когда важно не только избавиться от повторений, но и сохранить изначальный порядок данных, что может быть важным при работе с последовательностями или отображением данных в пользовательском интерфейсе.
При использовании LinkedHashSet стоит помнить, что этот класс обладает дополнительной нагрузкой по сравнению с HashSet из-за необходимости хранения порядка элементов. Однако, если сохранение порядка критично, это лучший выбор для удаления дубликатов в Java.
Метод удаления дубликатов с помощью Java Streams
Java Streams предоставляют современный и удобный способ удаления дубликатов из коллекций и массивов. Использование потока данных (Stream) позволяет делать операции более компактными и читаемыми. Для удаления повторяющихся элементов достаточно применить метод distinct(), который возвращает новый поток без дубликатов.
Пример использования Streams для удаления повторяющихся элементов из массива:
int[] array = {1, 2, 2, 3, 4, 4, 5};
Integer[] uniqueArray = Arrays.stream(array)  // создаем поток из массива
.distinct()    // удаляем дубликаты
.toArray();    // преобразуем в новый массив
Этот код создает поток из массива array, удаляет дубли с помощью distinct(), а затем преобразует результат обратно в массив. Метод distinct() работает за счет сравнения элементов на основе метода hashCode и equals.
Для более сложных случаев, например, при работе с объектами, необходимо удостовериться, что класс элементов правильно переопределяет методы hashCode() и equals(). Если этого не сделать, distinct() может работать неправильно.
Пример работы с объектами:
class Person {
String name;
int age;
public Person(String name, int age) {
this.name = name;
this.age = age;
}
@Override
public boolean equals(Object o) {
if (this == o) return true;
if (o == null || getClass() != o.getClass()) return false;
Person person = (Person) o;
return age == person.age && name.equals(person.name);
}
@Override
public int hashCode() {
return Objects.hash(name, age);
}
}
Person[] people = {
new Person("John", 25),
new Person("Jane", 30),
new Person("John", 25)
};
Person[] uniquePeople = Arrays.stream(people)
.distinct()
.toArray(Person[]::new);
После применения метода distinct() повторяющийся объект John будет удален, так как он имеет одинаковые значения полей name и age.
Использование Java Streams позволяет писать более лаконичный и декларативный код, который легко расширяется и поддерживается. Этот метод идеально подходит для работы с большими коллекциями данных, так как операции выполняются лениво, что уменьшает количество ненужных вычислений.
- Преимущества: компактность, читаемость кода, поддержка функционального подхода.
- Ограничения: требует хорошего понимания работы с потоками, может быть менее эффективным в специфических случаях с маленькими объемами данных.
Удаление повторяющихся элементов без использования коллекций
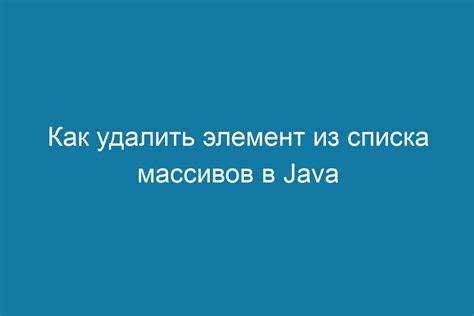
Для удаления дубликатов можно пройти по массиву и сохранить уникальные элементы в новый массив. Важно помнить, что в процессе поиска нужно проверить, был ли элемент уже добавлен, что требует дополнительной логики для сравнения значений.
Пример удаления повторяющихся элементов из массива целых чисел:
int[] array = {1, 2, 2, 3, 4, 4, 5};
int n = array.length;
int[] result = new int[n];
int count = 0;
for (int i = 0; i < n; i++) {
boolean isDuplicate = false;
for (int j = 0; j < count; j++) {
if (array[i] == result[j]) {
isDuplicate = true;
break;
}
}
if (!isDuplicate) {
result[count++] = array[i];
}
}
int[] uniqueArray = Arrays.copyOf(result, count);
В этом примере создается новый массив result, в который добавляются только уникальные элементы из исходного массива array. Для каждого элемента проверяется, был ли он уже добавлен в result. Если элемент повторяется, он пропускается.
После завершения работы с циклом, массив result может содержать пустые ячейки в конце, поэтому используется метод Arrays.copyOf(), чтобы создать новый массив с актуальным размером, содержащим только уникальные элементы.
Этот метод прост и понятен, но его недостаток заключается в том, что время выполнения пропорционально квадрату размера массива – O(n^2), что может быть неэффективно при работе с большими объемами данных. Тем не менее, он не требует использования внешних коллекций и может быть полезен в случаях с небольшими данными или ограничениями на память.
Для улучшения производительности можно использовать дополнительные структуры данных, такие как битовые массивы или другие оптимизированные подходы, но их использование требует дополнительной логики для обработки. В случае, если производительность не критична, этот метод будет достаточно хорош для базовых задач по удалению дубликатов.
Как удалять дубли из массива целых чисел
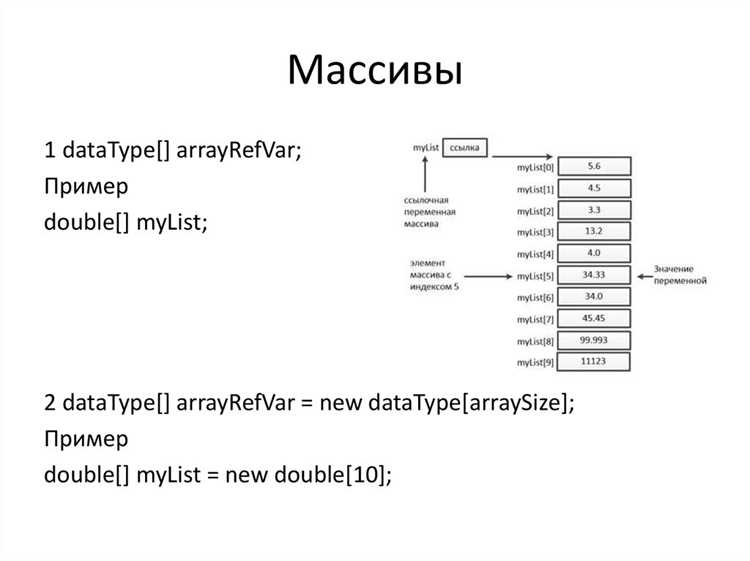
Для начала можно воспользоваться методом, который основывается на использовании дополнительного массива. Мы будем перебирать элементы исходного массива и добавлять уникальные элементы в новый массив. Этот метод подходит, когда не требуется использовать сторонние коллекции.
Пример удаления дубликатов с использованием дополнительного массива:
int[] array = {1, 2, 2, 3, 4, 4, 5};
int[] temp = new int[array.length];
int j = 0;
for (int i = 0; i < array.length; i++) {
boolean isDuplicate = false;
for (int k = 0; k < j; k++) {
if (array[i] == temp[k]) {
isDuplicate = true;
break;
}
}
if (!isDuplicate) {
temp[j++] = array[i];
}
}
int[] uniqueArray = Arrays.copyOf(temp, j);
В этом примере мы создаем временный массив temp, в который добавляются только уникальные элементы. Для каждого элемента массива array проверяется, был ли он уже добавлен в temp. Если элемент уникален, он добавляется в temp, а в конце результат копируется в новый массив uniqueArray.
Этот метод эффективен с точки зрения простоты, но его недостаток – линейная проверка каждого элемента на дубли, что приводит к времени выполнения O(n^2), что не всегда подходит для больших массивов.
Альтернативно можно использовать коллекцию HashSet, которая автоматически исключает дубли. Это решение работает быстрее, но требует преобразования массива в коллекцию и обратно.
Пример с использованием HashSet:
int[] array = {1, 2, 2, 3, 4, 4, 5};
Set set = new HashSet<>();
for (int num : array) {
set.add(num);
}
Integer[] uniqueArray = set.toArray(new Integer[0]);
В данном случае коллекция HashSet автоматически удаляет дубликаты, так как она не позволяет содержать одинаковые элементы. Результат затем можно преобразовать обратно в массив с помощью метода toArray().
Метод с HashSet имеет значительно лучшее время выполнения – O(n), что делает его предпочтительным для больших массивов. Однако стоит учитывать, что этот метод не сохраняет порядок элементов, и если порядок важен, нужно использовать LinkedHashSet.
Если порядок элементов важен и требуется избежать использования коллекций, можно применить метод с дополнительным массивом, который сохраняет порядок, но работает медленнее. В противном случае использование HashSet является более быстрым и эффективным решением для удаления дубликатов в массиве целых чисел.
Сравнение различных методов удаления дубликатов по времени выполнения

Время выполнения алгоритмов для удаления дубликатов зависит от выбранного метода и размера исходного массива. Рассмотрим сравнение нескольких популярных методов с точки зрения их временной сложности.
1. Использование дополнительного массива: В этом методе мы проходим по массиву и для каждого элемента проверяем, присутствует ли он уже в новом массиве. Время выполнения – O(n^2), так как для каждого элемента необходимо выполнить проверку на наличие дубликатов среди уже добавленных элементов. Это самый медленный метод, особенно при больших размерах массива.
int[] array = {1, 2, 2, 3, 4, 4, 5};
int[] temp = new int[array.length];
int j = 0;
for (int i = 0; i < array.length; i++) {
boolean isDuplicate = false;
for (int k = 0; k < j; k++) {
if (array[i] == temp[k]) {
isDuplicate = true;
break;
}
}
if (!isDuplicate) {
temp[j++] = array[i];
}
}
Этот метод полезен при маленьких объемах данных, но будет значительно медленным для больших массивов из-за квадратичной сложности.
2. Использование HashSet: Этот метод позволяет удалять дубликаты за время O(n), где n – количество элементов в массиве. HashSet работает быстрее, поскольку операции вставки и проверки наличия элемента в хеш-таблице выполняются за константное время O(1) в среднем. Однако, если порядок элементов имеет значение, следует использовать LinkedHashSet, который сохраняет порядок, но немного медленнее из-за дополнительных операций.
int[] array = {1, 2, 2, 3, 4, 4, 5};
Set set = new HashSet<>();
for (int num : array) {
set.add(num);
}
Integer[] uniqueArray = set.toArray(new Integer[0]);
Этот метод подходит для больших массивов, так как работает значительно быстрее, чем использование дополнительного массива, благодаря линейной сложности.
3. Использование Java Streams: Метод с использованием потоков данных позволяет выполнить удаление дубликатов за время O(n). Преимущество этого подхода в компактности и чистоте кода. Однако, на практике производительность может немного снизиться из-за overhead, связанного с использованием потоков, особенно при большом количестве операций.
int[] array = {1, 2, 2, 3, 4, 4, 5};
Integer[] uniqueArray = Arrays.stream(array)
.distinct()
.toArray();
Этот метод также имеет линейную сложность, но может быть менее эффективным в специфических случаях, особенно при сложных операциях с потоками.
4. Удаление дубликатов без использования коллекций: Этот метод использует дополнительные циклы для проверки каждого элемента и добавления уникальных значений в новый массив. Время выполнения зависит от количества проверок, что приводит к сложности O(n^2). Этот метод, как и использование дополнительного массива, плохо подходит для больших данных.
5. Использование LinkedHashSet для сохранения порядка: В случае, если необходимо сохранить порядок элементов, можно использовать LinkedHashSet. Время выполнения этого метода также будет O(n), так как операции добавления элементов в LinkedHashSet выполняются за амортизированное время O(1). Этот метод идеально подходит, если порядок имеет значение, но следует помнить, что LinkedHashSet может работать немного медленнее, чем HashSet, из-за необходимости поддержания порядка.
Итак, для большинства случаев удаления дубликатов оптимальными являются методы с использованием HashSet или Streams, поскольку они имеют линейную сложность и обеспечивают хорошую производительность. Метод с дополнительным массивом или использование циклов для проверки наличия дубликатов эффективны только для маленьких массивов, так как их сложность O(n^2) делает их менее подходящими для обработки больших объемов данных.
Вопрос-ответ:
Как удалить повторяющиеся элементы из массива целых чисел в Java без использования коллекций?
Для удаления повторяющихся элементов без использования коллекций можно воспользоваться подходом с дополнительным массивом. В этом случае вы создаете новый массив, в который добавляются только уникальные элементы. Для каждого элемента исходного массива проверяется, встречался ли он уже в новом массиве. Такой метод имеет сложность O(n²), что делает его неэффективным для больших массивов, но он подходит для небольших данных, когда не хочется использовать коллекции.
Как работает HashSet при удалении дубликатов из массива в Java?
HashSet автоматически удаляет повторяющиеся элементы, так как этот класс не позволяет добавлять одинаковые объекты. Для удаления дубликатов из массива можно преобразовать его в HashSet, и все повторяющиеся элементы будут удалены. Это решение имеет сложность O(n), что делает его быстрым и эффективным для больших объемов данных. Однако, стоит отметить, что HashSet не сохраняет порядок элементов, поэтому, если порядок имеет значение, нужно использовать LinkedHashSet.
Как сохранить порядок элементов при удалении дубликатов в Java?
Чтобы сохранить порядок элементов при удалении дубликатов, можно использовать LinkedHashSet. Этот класс работает аналогично HashSet, но при этом сохраняет порядок добавления элементов. Если требуется удалить дубликаты и сохранить их порядок, использование LinkedHashSet будет оптимальным решением. Однако стоит помнить, что этот метод немного медленнее, чем HashSet, из-за дополнительной работы по поддержанию порядка.
Что выбрать для удаления дубликатов в массиве: Java Streams или HashSet?
Java Streams и HashSet оба имеют линейную сложность O(n) и хорошо подходят для удаления дубликатов. Java Streams предлагает более компактный и декларативный синтаксис, а также поддерживает удобные методы, такие как distinct(). Однако, Streams может быть менее эффективным в случаях с большими данными из-за дополнительной нагрузки. HashSet, с другой стороны, может быть немного быстрее при работе с простыми массивами, поскольку операция добавления в коллекцию выполняется быстрее. Выбор зависит от предпочтений и особенностей задачи — если важна читаемость и краткость кода, лучше использовать Streams, если же нужна максимальная производительность, предпочтительнее HashSet.

 Загрузка...